Lokalne modele LLM bez chmury: jak zintegrować Ollamę z desktopowym workflow w Tauri
Praktyczny poradnik tworzenia natywnych narzędzi wspierających codzienną pracę programisty – działających w 100% offline i z poszanowaniem prywatności.
Praktyczny poradnik tworzenia natywnych narzędzi wspierających codzienną pracę programisty – działających w 100% offline i z poszanowaniem prywatności.
Prywatność i niezależność od chmurowych subskrypcji to fundament każdego projektu rozwijanego w AI-Software.
W tym artykule omawiam architekturę naszych narzędzi, które łączą lekki interfejs Tauri (Rust) z lokalnym demonem Ollama lub llama.cpp.
⚡ Najważniejsze wnioski:
- 🔒 Poufność kodu: żadne zapytanie, log ani fragment kodu nie opuszcza lokalnego dysku NVMe.
- 💰 Brak opłat za tokeny: modele Llama 3, Qwen 2.5 i Mistral działają z pełną mocą GPU (8–16 GB VRAM).
- ✈️ Praca offline: stabilne działanie w samolocie, w pociągu i w odizolowanych sieciach przemysłowych.
1. Rekomendowane modele lokalne: VRAM a jakość
Poniżej ściągawka z modelami, które najlepiej sprawdzają się w codziennej pracy programistycznej:
| Model | Kwantyzacja | Wymagany VRAM | Zastosowanie |
|---|---|---|---|
| Qwen 2.5 Coder 7B | Q4_K_M | 5,2 GB | Generowanie i refaktoryzacja kodu Rust/TypeScript |
| Llama 3.2 3B Instruct | Q8_0 | 3,8 GB | Szybkie streszczenia, formatowanie JSON |
| Mistral NeMo 12B | Q4_K_M | 8,4 GB | Zaawansowane wnioskowanie i dokumentacja |
| DeepSeek Coder V2 Lite | Q5_K_M | 11,2 GB | Złożone zadania architektoniczne i algorytmiczne |
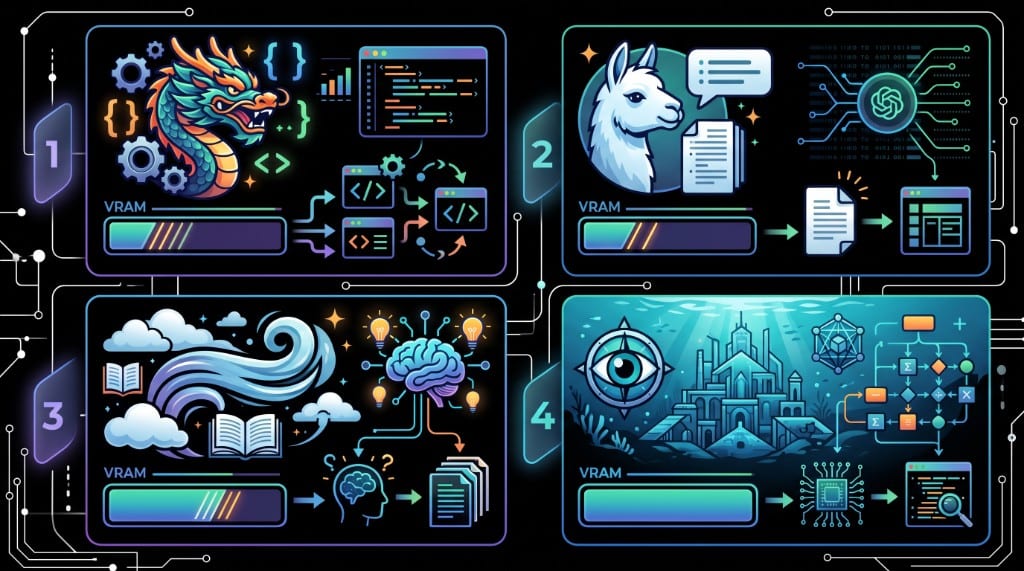
Integracja lokalnego modelu językowego (LLM) z interfejsem aplikacji desktopowej
2. Strumieniowanie tokenów przez zdarzenia Tauri (emit/listen)
Backend w Ruście asynchronicznie (Tokio) odbiera strumień tokenów z Ollamy i każdy token od razu publikuje jako zdarzenie Tauri (emit). Komponent React subskrybuje to zdarzenie funkcją listen z pakietu @tauri-apps/api/event, dzięki czemu tekst pojawia się w interfejsie w czasie rzeczywistym:
// Odbiór strumienia tokenów z demona Ollama i przekazanie ich do UI jako zdarzeń Tauri
let mut stream = client.generate_stream(request).await?;
while let Some(res) = stream.next().await {
    let token = res?.response;
    app_handle.emit("llm-token", token)?;
}
Stanowisko programistyczne z asynchronicznym strumieniowaniem tokenów AI
Więcej gotowych skryptów automatyzujących integrację znajdziesz w sekcji Biblioteka skryptów.
3. Stanowisko i wymagania
Nie ma osobnej karty produktu „Ollama + Tauri” – to wzorzec, który stosuję w narzędziach desktopowych (m.in. w lokalnym sorterze z opcjonalnym modelem VLM).
| Element | Praktyczne minimum |
|---|---|
| Środowisko uruchomieniowe | Ollama lub llama.cpp na localhost |
| VRAM | Dobierz kwantyzację z tabeli w sekcji 1 do swojej karty graficznej |
| Sieć | Demon nasłuchuje lokalnie – nie wystawiaj go na interfejs publiczny |
| Interfejs | Tauri 2.x + zdarzenia Tauri (emit w Ruście, listen w React) – szkic powyżej |
4. Jak to złożyć
- Zainstaluj Ollamę i pobierz jeden model z tabeli (zacznij od 3B lub 7B, nie od 12B).
- Zanim podłączysz interfejs, sprawdź z terminala, czy odpowiada
localhost:11434. - W Tauri strumieniuj tokeny przez backend w Ruście i zdarzenia Tauri, a nie przez przeglądarkowy
fetchdo chmury. - Prompty i logi zostaw na dysku – bez telemetrii „do celów diagnostycznych”.
Gotowe skrypty pomocnicze: Biblioteka skryptów. Karta narzędzia z lokalnym VLM: VideoSorterLocal.