Lokale LLMs ohne Cloud: So integrieren Sie Ollama in einen Desktop-Workflow mit Tauri
Praxisleitfaden für native Entwicklerwerkzeuge, die zu 100 % offline laufen und die Privatsphäre wahren.
Praxisleitfaden für native Entwicklerwerkzeuge, die zu 100 % offline laufen und die Privatsphäre wahren.
Datenschutz und Unabhängigkeit von Cloud-Abonnements bilden das Fundament aller Projekte, die wir bei AI-Software entwickeln.
In diesem Artikel beschreibe ich die Architektur unserer Werkzeuge, die eine schlanke Tauri-Oberfläche (Rust) mit einem lokalen Ollama- bzw. llama.cpp-Daemon verbinden.
⚡ Das Wichtigste in Kürze:
- 🔒 Vertraulicher Code: Keine Anfrage, kein Log und kein Codefragment verlässt die lokale NVMe-SSD.
- 💰 Keine Token-Kosten: Llama 3, Qwen 2.5 und Mistral laufen mit voller GPU-Leistung (8–16 GB VRAM).
- ✈️ Offline-Betrieb: Zuverlässiges Arbeiten im Flugzeug, im Zug und in abgeschotteten Industrienetzen.
1. Empfohlene lokale Modelle: VRAM und Qualität
Die folgende Übersicht zeigt Modelle, die sich im Entwickleralltag besonders bewährt haben:
| Modell | Quantisierung | Benötigter VRAM | Einsatzzweck |
|---|---|---|---|
| Qwen 2.5 Coder 7B | Q4_K_M | 5,2 GB | Generieren und Refaktorieren von Rust-/TypeScript-Code |
| Llama 3.2 3B Instruct | Q8_0 | 3,8 GB | Schnelle Zusammenfassungen, JSON-Formatierung |
| Mistral NeMo 12B | Q4_K_M | 8,4 GB | Anspruchsvolles Reasoning und Dokumentation |
| DeepSeek Coder V2 Lite | Q5_K_M | 11,2 GB | Komplexe Architektur- und Algorithmusaufgaben |
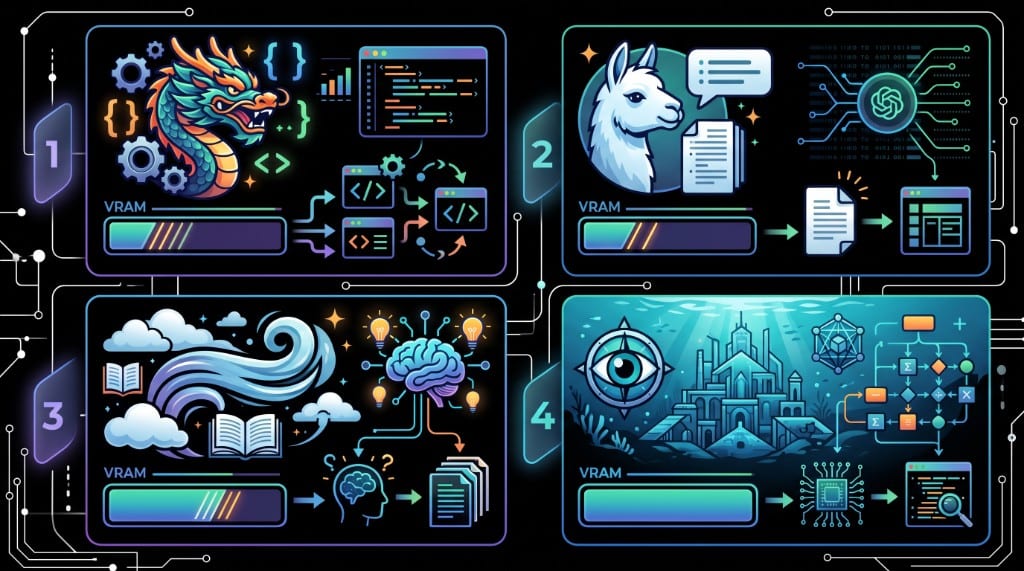
Lokales Sprachmodell (LLM), integriert in eine Desktop-Oberfläche
2. Token-Streaming über Tauri-Events (emit/listen)
Das Rust-Backend liest den Token-Stream von Ollama asynchron (Tokio) und veröffentlicht jedes Token sofort als Tauri-Event (emit). Die React-Komponente abonniert dieses Event mit listen aus @tauri-apps/api/event, sodass der Text in Echtzeit in der Oberfläche erscheint:
// Token-Stream vom Ollama-Daemon empfangen und als Tauri-Events an die UI weitergeben
let mut stream = client.generate_stream(request).await?;
while let Some(res) = stream.next().await {
    let token = res?.response;
    app_handle.emit("llm-token", token)?;
}
Entwicklerarbeitsplatz mit KI-Token-Streaming in Echtzeit
Weitere fertige Integrationsskripte finden Sie im Bereich Skripte.
3. Arbeitsplatz und Voraussetzungen
Ein eigenes Produkt „Ollama + Tauri“ gibt es nicht – es handelt sich um ein Muster, das ich in unseren Desktop-Tools einsetze (u. a. im lokalen Video-Sorter mit optionalem VLM).
| Komponente | Praktisches Minimum |
|---|---|
| Runtime | Ollama oder llama.cpp auf localhost |
| VRAM | Quantisierung aus der Tabelle in Abschnitt 1 an Ihre GPU anpassen |
| Netzwerk | Daemon nur lokal binden, nie an einer öffentlichen Schnittstelle bereitstellen |
| Oberfläche | Tauri 2.x plus Tauri-Events (emit in Rust, listen in React) – siehe Skizze oben |
4. Schritt für Schritt
- Ollama installieren und ein Modell aus der Tabelle herunterladen (mit 3B oder 7B beginnen, nicht mit 12B).
- Im Terminal prüfen, ob
localhost:11434antwortet, bevor Sie die Oberfläche anbinden. - Tokens in Tauri über das Rust-Backend und Tauri-Events streamen – nicht per Browser-
fetchan eine Cloud-API. - Prompts und Logs auf der Festplatte belassen – keine Telemetrie „zu Diagnosezwecken“.
Hilfsskripte: Skripte. Produktseite mit optionalem lokalem VLM: VideoSorterLocal.